AIクローラー対策とは、生成AI事業者のクローラーに対し、自社サイトの情報を「学習」や「AI検索での引用」に使ってよいかを決め、robots.txtなどで制御・整備することです。BtoBサイトでは全面許可か全面拒否かの二択ではありません。検索・引用用は許可し、学習用はコンテンツに応じて制限する設計が検討しやすい方針です。
この記事では、AIクローラーの種類、許可・拒否それぞれの影響、判断基準、robots.txtの記述例、構造化データとクロール可能性の整備手順、設定後の確認方法までを順に解説します。
AIクローラーとは?検索エンジンのクローラーとの違い
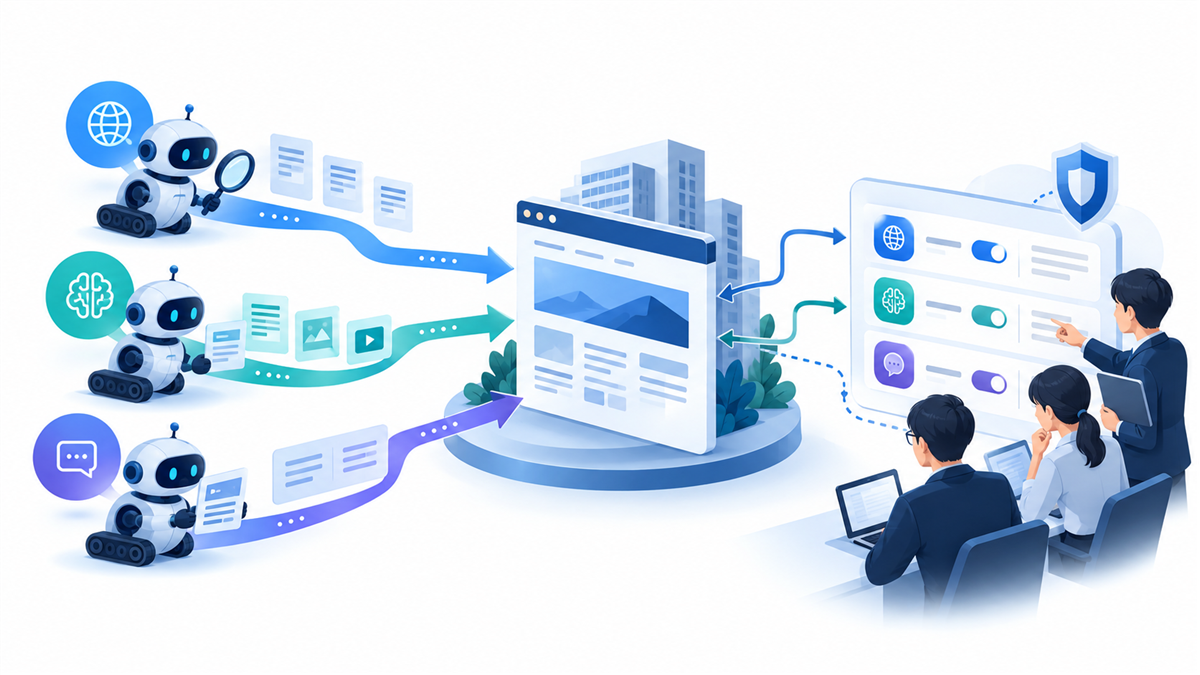
AIクローラーとは、生成AIサービスを提供する事業者が、Webページの情報を自動で取得するために使うプログラムです。従来の検索エンジンのクローラーは、検索結果に表示するためにページを収集・索引化します。AIクローラーは、それに加えてAIモデルの学習や、AIの回答の根拠となる情報の取得にも使われる点が異なります。
AIクローラーの用途は3種類
- 学習用:AIモデルの学習データとしてWebページを収集する
- 検索・引用用:AI検索やAIの回答で、情報源として参照・引用するためにページを取得する
- ユーザー操作に応じた取得:利用者がAIサービス上でURLを指定したり質問したりしたときに、その場でページを読み込む
3つの用途を区別すると、「学習には使われたくないが、AI検索で自社情報が正しく引用されるのは歓迎する」といった目的別の方針を設定できます。
主要なAIクローラーのユーザーエージェント
クローラーはユーザーエージェントと呼ばれる名前でアクセス元を名乗り、robots.txtではこの名前を指定して制御します。代表的なものは次のとおりです。
- OpenAI:GPTBot(学習用)、OAI-SearchBot(検索・引用用)、ChatGPT-User(ユーザー操作に応じた取得)
- Anthropic:ClaudeBot(学習用)、Claude-SearchBot(検索・引用用)、Claude-User(ユーザー操作に応じた取得)
- Google:Google-Extended(Geminiなどの生成AIでの利用をまとめて制御するための名前)
- Perplexity:PerplexityBot(検索・引用用)
- Common Crawl:CCBot(公開データセットの収集用)
ユーザーエージェントの名前や用途は、各事業者の判断で追加・変更されることがあります。設定前には、各事業者が公開している最新のドキュメントを確認してください。
なぜ今、BtoBサイトでAIクローラー対策が必要なのか
見込み顧客の情報収集にAI検索やAIアシスタントが加わり、自社サイトがAIにどう読まれるかが集客に関わるようになったためです。
- 課題の調査やサービス比較の段階で、AIの回答を参考にする場面が増えている
- クローラーを意図せず拒否していると、AIの回答で自社の情報が参照されにくくなる
- 自社の一次情報が読まれないと、古い情報や第三者の情報をもとにAIが自社を説明してしまう可能性がある
- 一方で、有料資料や独自ノウハウが学習データとして使われることを懸念する企業もある
AIクローラー対策は、情報を守る施策であると同時に、自社の情報を正しく届けるためのマーケティング施策でもあります。
robots.txtでできること・できないこと
robots.txtはAIクローラーへのアクセスルールを示す基本の手段ですが、強制力はないため、他の手段と組み合わせて考えます。
robots.txtは、サイトのルートに置くテキストファイルで、「どのクローラーに、どのパスへのアクセスを許可・拒否するか」を記述します。AIクローラーの多くは、サイトにアクセスすると最初にrobots.txtを読み込み、ルールに従って取得してよいページを判断します。
AIクローラーはrobots.txtを守るのか
robots.txtに従うかどうかはクローラーを運用する事業者の方針によるため、すべてのクローラーが守る保証はありません。robots.txtには次の限界があります。
- 強制力はない:ルールを守らないクローラーのアクセスを技術的に止めるものではない
- 過去の取得分には及ばない:設定は今後のクロールに対するもので、取得済みデータの扱いは各事業者の方針による
- ユーザー操作に応じた取得は扱いが異なる場合がある:利用者の指示で読み込むエージェントについては、robots.txtの扱いが事業者ごとに異なることがある
robots.txt以外の制御手段
- ログイン認証:会員向け資料など、公開すべきでない情報は認証の内側に置く
- WAF・CDNのボット対策機能:ルールを守らないボットや過剰なアクセスを遮断する。AIとサイバーセキュリティの守り方の観点からも設定を確認する
- CMSのプラグインやサーバーの設定機能:robots.txtの編集やAIクローラーの遮断を管理画面から行える場合がある。設定内容が自社の方針と一致しているかを必ず確認する
確実に止めたい情報は認証で保護し、広く知ってもらいたい情報はどの手段でも意図せず拒否していないかを確認することが、対策の第一歩です。
AIクローラーを許可した場合と拒否した場合の影響
許可・拒否の影響はクローラーの用途ごとに異なるため、学習用と検索・引用用を分けて整理します。
- 検索・引用用を許可:AI検索の回答で自社ページが参照・引用される可能性が残る。クロールによるサーバー負荷は発生する
- 検索・引用用を拒否:AIの回答で自社の情報が参照されにくくなり、第三者の情報をもとに説明される可能性が高まる
- 学習用を許可:AIモデルが自社や業界の情報を学ぶ材料になり得る。その代わり、独自コンテンツも学習データとして使われる
- 学習用を拒否:今後のクロールによる学習利用を抑えられる。過去の取得分や第三者サイトへの転載には及ばない
Googleは、Google-Extendedの設定はGoogle検索への掲載や順位には影響しないと説明しています。通常の検索のクロールはGooglebotが担っているためです。
対策にかかる工数と得られる効果の考え方
AIクローラー対策の投資対効果は、作業工数と、AI経由で正しく見つけてもらえる状態の価値を比べて判断します。
- 主な工数:現状調査、コンテンツの棚卸し、社内合意、robots.txtと構造化データの実装、定期的な見直し
- 期待できる効果:AI検索での自社情報の参照機会の確保、誤った説明のリスク低減、守るべき情報の整理
- 測り方:アクセスログでのクローラーの訪問状況と、AIの回答での自社の言及・引用状況の定点確認
AIの回答での言及状況を継続的に追う場合は、AI検索対策ツールを企業規模・予算で比較する基準も参考になります。
BtoBサイトで許可・拒否を判断する4つの基準
BtoBサイトでは、コンテンツの性質、AI経由で見つけてもらう価値、学習利用への方針と権利関係、サーバー負荷と運用体制の4つで判断すると方針を決めやすくなります。
基準1:コンテンツの性質
そのコンテンツが「集客のための情報」か「商品そのもの」かを見極めます。サービスの特徴、導入の流れ、よくある質問、会社情報は、AIを通じて見込み顧客に届けば集客につながる可能性があります。独自の調査レポートやノウハウ資料のように情報自体が営業上の価値を持つものは、学習利用の拒否を検討します。
基準2:AI経由で見つけてもらう価値
自社の正確な情報をAIに参照してもらうことを重視するなら、検索・引用用のクローラーは許可するのが基本です。許可したうえで引用されやすいページにする条件は、AI検索で引用されるBtoBサイトのコンテンツ条件と見直し手順で解説しています。
基準3:学習利用への方針と権利関係
学習利用をどう考えるかは企業の方針によって分かれます。取引先から提供を受けた資料、外部の執筆者・制作会社の著作物、利用許諾の範囲が限られた写真や図版を掲載している場合は、権利関係の観点からも判断が必要です。法務部門や知的財産の担当者と方針をすり合わせておきます。
基準4:サーバー負荷と運用体制
アクセスログを見て、特定のクローラーのアクセスが表示速度や安定性に影響していないかを確認します。robots.txtのルールは新しいクローラーの登場や事業方針の変化に合わせて見直す必要があるため、誰が管理し、どの頻度で見直すかも判断材料に含めます。
よく取られる4つの方針パターン
- 全面許可:学習用・検索・引用用とも許可する。公開情報の大半が集客目的で、学習利用にも抵抗がないときに選ばれる
- 検索・引用は許可し、学習は拒否:AI検索での引用は歓迎しつつ、学習データとしての利用は控えたいとき。BtoBサイトでは検討しやすい中間的な方針
- ディレクトリ単位で制御:サービスページやコラムは許可し、資料ダウンロードや会員向け領域だけを拒否したいとき
- 全面拒否:サイト全体の情報を守る必要があるとき。AI経由で見つけてもらう機会も失う点に注意する
実務では、パターン2とパターン3を組み合わせる設計が扱いやすい方法です。
robots.txtの書き方:方針別の記述例
robots.txtでは、ユーザーエージェントごとのグループに、許可(Allow)と拒否(Disallow)のパスを書きます。
検索・引用は許可し、学習は拒否する例
User-agent: GPTBot
Disallow: /
User-agent: ClaudeBot
Disallow: /
User-agent: Google-Extended
Disallow: /
User-agent: CCBot
Disallow: /
User-agent: OAI-SearchBot
Allow: /
User-agent: Claude-SearchBot
Allow: /
User-agent: *
Allow: /
Sitemap: https://www.example.com/sitemap.xml
特定ディレクトリだけを学習用クローラーから除外する例
User-agent: GPTBot
Disallow: /download/
Disallow: /members/
ClaudeBotなど他の学習用クローラーにも同じ方針を適用する場合は、それぞれのグループに同じルールを書きます。
記述時の注意点
- クローラーは、自分の名前が書かれたグループがあればそのルールに従い、「User-agent: *」のルールは適用されない。個別に指定したグループには必要なルールをすべて書く
- 「Disallow: /」をすべてのクローラー向けに書くと、検索エンジンのクローラーも拒否してしまう。記述ミスは検索流入に直接影響するため、公開前に必ず確認する
- robots.txtに秘匿したいディレクトリ名を書くと、かえってその存在を知らせることになる
- サンプルのドメインやディレクトリ名は、自社サイトの実際の構成に置き換える
AIクローラー対策の整備手順
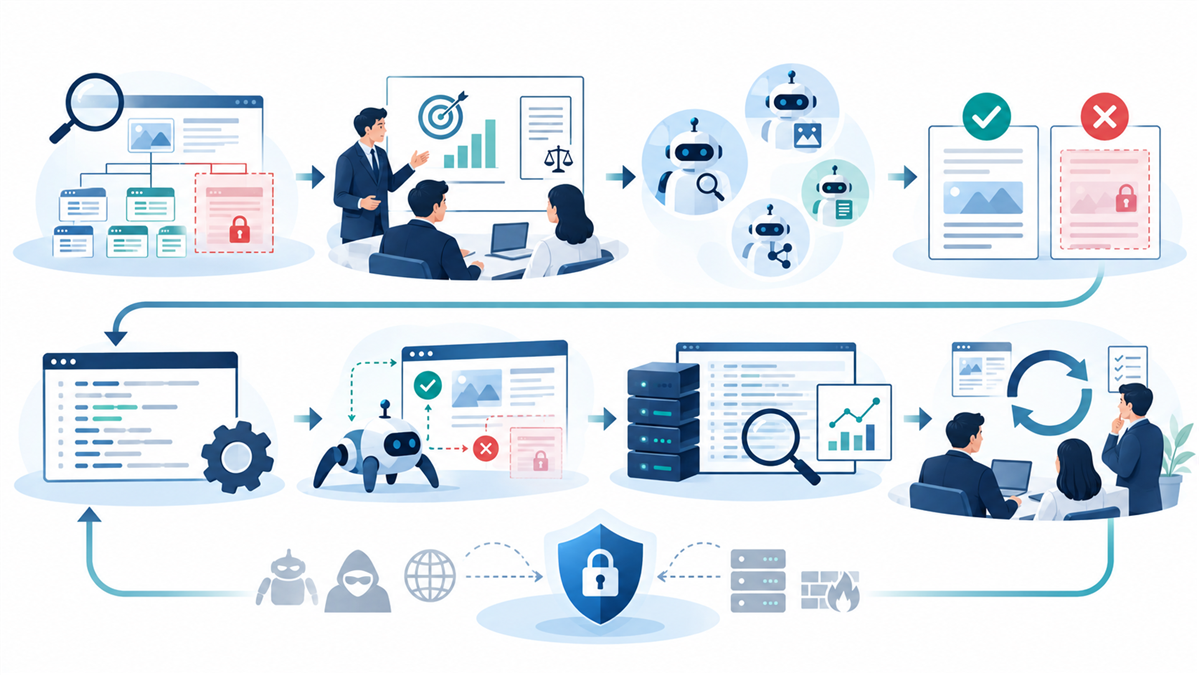
方針の決定から実装、検証までは、次の7つのステップで進めます。マーケティング部門だけでなく、サーバー・CDN・CMSを扱うシステム担当者と一緒に進めると、設定の抜け漏れを防げます。
ステップ1:現状を把握する
- 現在のrobots.txtの内容(ブラウザで「サイトのURL/robots.txt」を開くと確認できる)
- サーバーやCDNのアクセスログに、どのAIクローラーがどの程度アクセスしているか
- WAFやCDNのボット対策機能が、AIクローラーを意図せずブロックしていないか
- CMSやプラグインが、robots.txtを自動生成・上書きしていないか
WAFやCDNのボット対策は、管理者が意識しないうちにAIクローラーを遮断していることがあるため、robots.txtだけで判断しないようにします。
ステップ2:コンテンツを棚卸しして分類する
サイト内のコンテンツをディレクトリ単位で一覧にし、「広く知ってもらいたい情報」「学習には使われたくない情報」「公開範囲を限定すべき情報」に分類します。URL構造が整理されていないとディレクトリ単位の制御がしにくいため、必要に応じてURL設計も見直します。
ステップ3:方針を決めて社内で合意する
分類結果と4つの判断基準をもとに、クローラーの種類ごと、ディレクトリごとの方針を決めます。法務部門、情報システム部門、コンテンツ制作の担当者を交えて合意し、決めた方針と理由を文書に残すと、後から方針が覆るリスクを減らせます。
ステップ4:robots.txtを設定する
前述の記述例を参考に、合意した方針をrobots.txtに記述します。CMSやプラグインで管理している場合は、手動の編集が上書きされない設定になっているかもあわせて確認します。
ステップ5:構造化データを整備する
構造化データとは、ページの内容を検索エンジンやAIが理解しやすい形式で記述したデータです。schema.orgの語彙を使い、JSON-LD形式で記述するのが一般的です。BtoBサイトでは次の種類から整備を始めます。
- Organization:会社名、ロゴ、所在地、問い合わせ先などの企業の基本情報
- WebSite・BreadcrumbList:サイト名とサイト内の階層構造
- Article:コラム記事のタイトル、著者、公開日、更新日
- Service・FAQPage:提供サービスの概要と、よくある質問
構造化データの内容はページに表示されている内容と一致させ、実装後はGoogleのリッチリザルトテストやSchema Markup Validatorで確認します。構造化データはAIによる引用を保証するものではなく、情報を正しく理解してもらうための土台です。実装範囲の決め方はBtoBサイトの構造化データの実装範囲と検証手順で解説しています。
ステップ6:クロール可能性を整える
AIクローラーを許可しても、ページの情報を読み取れなければ意味がありません。次の観点で点検します。
- 重要な情報がHTMLに含まれているか:JavaScriptを実行しない、または実行が限定的なクローラーもあるため、サービス内容や会社情報はHTMLに直接記述する
- 情報がPDFや画像だけに載っていないか:サービスの特徴や料金体系の要点は、HTMLのテキストでも記載する
- XMLサイトマップが最新か:公開中のページが漏れなく含まれ、削除済みのページが残っていないかを確認する
- canonicalとnoindexの設定が正しいか:意図しないページにnoindexが付いていないかを確認する
- ステータスコードが適切か:存在しないページが404を返し、リダイレクトが連鎖していないかを確認する
- 内部リンクと見出し構造、応答速度:重要なページへ内部リンクでたどれ、サーバーの応答が安定しているかを確認する
ステップ7:検証し、定期的に見直す
設定を反映したら、次節のチェックリストで検証します。AIクローラーは今後も新しいものが登場し、各事業者の仕様も変わるため、四半期ごとなど見直しのタイミングをあらかじめ決めておきます。
AIクローラー対策の設定後チェックリスト
設定を反映した直後と定期見直しのたびに、次の項目を確認します。
- ブラウザで「サイトのURL/robots.txt」を開き、意図した内容が公開されている
- 「User-agent: *」に「Disallow: /」が書かれておらず、検索エンジンのクローラーを拒否していない
- Google Search Consoleのrobots.txtレポートで、読み込みエラーが出ていない
- アクセスログで、拒否したクローラーと許可したクローラーのアクセス状況が方針どおりに変化している
- WAF・CDNのボット対策機能が、許可したクローラーをブロックしていない
- CMSやプラグインの更新後に、robots.txtが上書きされていない
- 構造化データのテストでエラーが出ていない
- robots.txtにXMLサイトマップの場所が記載されている
- ユーザーエージェントの一覧が、各事業者の最新ドキュメントと一致している
- 次回の見直し日と担当者が決まっている
AIクローラー対策でよくある失敗と対処
よくある失敗の多くは、設定の範囲を誤るか、設定後の確認を怠ることで起こります。
- 検索エンジンまで拒否してしまう:「User-agent: *」に「Disallow: /」を書いてしまうケース。対処として、公開前に記述内容をレビューし、Search Consoleで確認する
- 学習用と検索用を区別せずに拒否する:学習だけを避けたかったのに検索・引用用まで拒否してしまうケース。対処として、ユーザーエージェントを用途別に指定する
- robots.txtだけで機密情報を守ろうとする:robots.txtには強制力がない。対処として、公開すべきでない情報は認証で保護する
- CMSの更新で設定が上書きされる:プラグインや設定変更でrobots.txtが書き換わるケース。対処として、更新作業のたびに内容を確認する手順を決める
- 設定して終わりにする:新しいクローラーへの対応が漏れ、方針と実態がずれていくケース。対処として、見直しの頻度と担当者を決めておく
よくある質問
robots.txtで拒否すれば、AIに一切使われなくなりますか?
いいえ。robots.txtはルールを守るクローラーにだけ効果がある仕組みで、すでに取得されたデータや第三者サイトに転載された情報には及びません。確実に守りたい情報は、認証などで公開範囲そのものを制限してください。
GPTBotは許可すべきですか?拒否すべきですか?
GPTBotは学習用のクローラーのため、自社コンテンツを学習に使われてよいかという方針で判断します。AI検索での引用はOAI-SearchBotが担うため、GPTBotを拒否してもOAI-SearchBotを許可すれば引用の機会は残せます。
ClaudeBotをブロックすると、Claudeの検索結果に出なくなりますか?
ClaudeBotは学習用で、検索・引用用にはClaude-SearchBotが使われます。ClaudeBotだけを拒否し、Claude-SearchBotを許可する設定にすれば、学習と検索・引用を分けて制御できます。
Google-Extendedを拒否すると、Google検索の順位に影響しますか?
Googleは、Google-Extendedの設定はGoogle検索への掲載や順位には影響しないと説明しています。Google検索のクロールはGooglebotが担っているため、Googlebotを拒否しない限り通常の検索には影響しません。
robots.txtとllms.txtの違いは何ですか?
robots.txtはクローラーのアクセスを許可・拒否するためのファイルで、llms.txtはAI向けにサイトの概要や重要なページを案内するために提案されている仕組みです。llms.txtはアクセスを制御するものではなく、広く標準化された仕様でもないため、robots.txt、構造化データ、クロール可能性の整備を優先します。
まとめ
AIクローラー対策は、「許可か拒否か」を一律に決めるのではなく、クローラーの用途とディレクトリごとに方針を決めて、正しく読み取れる状態を整えることが重要です。
- AIクローラーは「学習用」「検索・引用用」「ユーザー操作に応じた取得」に分けて考える
- BtoBサイトでは「検索・引用は許可し、学習は拒否」と「ディレクトリ単位の制御」の組み合わせが扱いやすい
- robots.txtには強制力がないため、守るべき情報は認証などで保護する
- WAF・CDN・CMSの設定も含めて、意図せず拒否していないかを確認する
- 構造化データとクロール可能性を整え、チェックリストで定期的に見直す
無料マーケティング診断のご案内
ハイ・ヴァーチュ・ラボは、AI駆動開発・システムインテグレーション・マーケティングを一気通貫で提供するテクノロジーパートナーです。プロジェクトの立ち上げから収益化まで、すべての工程を網羅しています。
AIクローラー対策は、robots.txtの記述だけでなく、WAF・CDNやCMSの設定、構造化データ、コンテンツ設計にまたがる取り組みです。「自社サイトの設定がAIクローラーにどう影響しているか分からない」「構造化データやサイト構造をどこから見直せばよいか判断できない」といったお悩みがあれば、無料マーケティング診断をご利用ください。現状を整理し、自社に合ったAIクローラー対策の進め方を一緒に検討します。